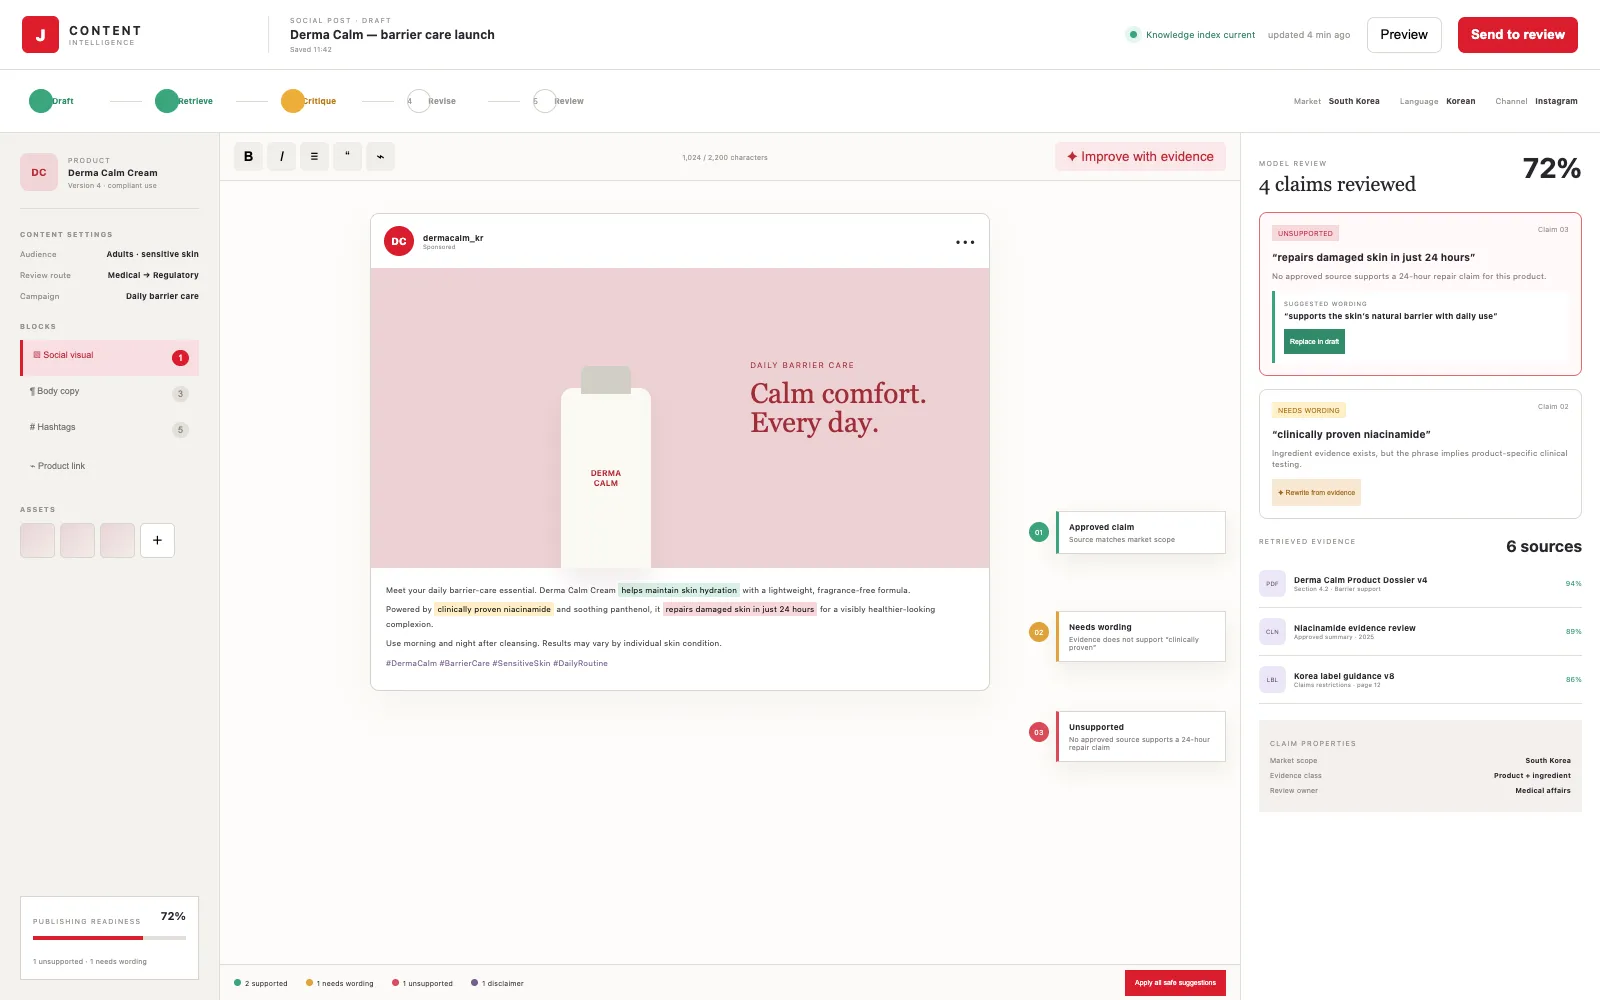
Задача
Для медицинской модели мало собрать большую папку изображений. Снимки из разных клиник отличаются форматами, разрешением, параметрами оборудования, правилами хранения и качеством метаданных. Разметка расходится между специалистами. А если исследования одного пациента случайно окажутся одновременно в обучающей и в проверочной выборке, метрики покажут отличный результат, которого на самом деле нет.
Отдельная ловушка — обучить модель не на медицинских признаках, а на клинике. Аппарат, формат, характерный артефакт обработки коррелируют с диагнозом ровно настолько, насколько один источник данных отличается от другого, и модель охотно выучит эту связь. Поэтому нужен был управляемый конвейер, в котором прослеживается каждое исследование: происхождение, история обработки, версия разметки и версия модели, которая на нём училась. Всего таких требований набралось одиннадцать, от регулярного приёма данных из нескольких источников до сохранения версии модели, входных данных и истории результата для последующего аудита.
Решение
Приём данных пакетами. Для каждого поступившего набора фиксируются источник, состав файлов, доступные медицинские метаданные, состояние импорта и результат первичной проверки. На входе проверяются целостность файлов и читаемость изображения, нормализуются форматы и кодировки метаданных, снимок сопоставляется с исследованием и источником, ищутся полные и близкие дубликаты. При больших объёмах и нестабильной передаче перезаливать весь набор нельзя, поэтому проблемные материалы отделяются от корректных и повторно обрабатывается только ошибочная часть.
Оригинал отдельно от производных. Исходные данные хранятся отдельно от результатов обработки, поэтому любую операцию предобработки можно повторить с другими параметрами, не трогая оригинал и не теряя происхождение результата.
Обезличивание до разметки. Прямые идентификаторы удаляются или заменяются внутренними кодами ещё до передачи материалов в разметку и обучение, а связь с источником живёт в защищённом служебном контуре. Доступ разделён по ролям: разметчик видит только необходимое для медицинской оценки, инженер работает с обезличенным датасетом, административные операции и выгрузки пишутся в журнал.
Подготовка, которая не стирает диагностику. Конвейер проверяет ориентацию и область исследования, нормализует размер и диапазон интенсивности, корректирует технические артефакты без потери диагностически значимых признаков, отбраковывает снимки недостаточного качества и применяет управляемую аугментацию. Параметры каждой операции сохраняются в истории обработки. Контроль качества выполняется до разметки и повторяется перед выпуском версии датасета.
Разметка с контролируемым разногласием. Очередь заданий со статусами и ответственными, единый справочник классов, часть данных размечается несколькими экспертами независимо. Расхождения между аннотациями выявляются, спорные случаи уходят на дополнительную проверку, утверждённая разметка блокируется от случайного изменения, а набор аннотаций версионируется вместе с версией схемы классов. Так отсутствие признака не путается с отсутствием разметки, а разные редакции медицинской классификации не смешиваются в одном датасете.
Версия датасета как объект. В неё входят ссылки на исходные исследования, подготовленные изображения, метки, параметры обработки и правила включения. Обучающая, валидационная и тестовая части делятся на уровне пациентов и источников, поэтому связанные снимки не расходятся по разным выборкам. Перед обучением формируется отчёт о составе версии из шести пунктов: принятые и исключённые исследования, распределение по классам, баланс источников, доля повторно проверенной разметки, причины исключения снимков и отличия от предыдущей версии.
Эксперименты не перезаписывают друг друга. Конфигурация, версия датасета, балансировка классов, аугментации только на обучающей части, промежуточные веса, журнал метрик по эпохам, ранняя остановка и выбор лучшей контрольной точки связаны с кодом и данными. Для любой версии восстанавливается, на чём и с какими параметрами она получена.
Валидация по срезам. Модель проверяется отдельно по каждому классу, клиническому источнику и типу качества снимка; анализируются пропуски патологии, ложные срабатывания и матрицы ошибок. Хороший результат на данных той же клиники, что участвовала в обучении, ничего не говорит об устойчивости на снимках другого оборудования. Поэтому в итоговую проверку входят отложенные данные и разрезы по клиникам, а заметное расхождение становится поводом для новой подготовки данных или нового цикла обучения.
Серверная выдача и обратная петля. Серверный слой принимает исследование, проверяет формат, применяет ту же версию предобработки, что использовалась при обучении, и возвращает структурированный результат: идентификатор обезличенного исследования, версию модели и пайплайна, оценки по классам, статус и предупреждения. В ответе есть и время выполнения, и история повторного анализа после обновления модели. Ошибочные и спорные примеры из валидации группируются и возвращаются экспертам. Уточнённая разметка попадает в следующую версию датасета.
Результат
У John Snow Labs появился управляемый процесс разработки медицинской модели. Клинические данные проходят сбор, обезличивание, очистку, разметку и контроль качества; датасеты и эксперименты версионируются. Модель проверяется на независимых источниках и отдаётся через серверный интерфейс, который явно отделяет автоматическую оценку от подтверждённого врачом заключения.
Команда может ответить на вопрос, который обычно остаётся без ответа: почему изменилось поведение модели. Обучение воспроизводится, две версии сравниваются без одновременной смены алгоритма, разметки и состава выборки, а конкретные ошибки возвращаются на медицинскую проверку. Специалист получает очередь исследований, упорядоченную по приоритету.
Наша роль в проекте — серверная часть. Мы отвечали за импорт и систематизацию данных из клинических источников, обработку ошибок загрузки, обезличивание, хранение метаданных, подготовку данных для разметки и сборку утверждённых версий датасета. Ещё на нас были инфраструктура воспроизводимого обучения со связью экспериментов и версий данных и серверный интерфейс модели с проверкой входных данных, журналированием версий и корректной выдачей результата внешней системе.