Задача
В большой распределённой организации информация размазана по почте, мессенджерам, интранету, видеосервисам, LMS, файловым хранилищам и локальным порталам подразделений. Следствие знакомое: человек получает рассылки, которые к нему не относятся, пропускает те, что относятся, и тратит время на поиск актуальной версии документа или записи встречи. У коммуникационной команды при этом нет ответа на простой вопрос: материал посмотрели или его только доставили.
Продукт должен был дать единый редакционный инструмент коммуникациям, HR, продажам и руководству и собрать разные форматы в одну контентную модель. Аудиторию нужно было сегментировать по структуре организации, а порядок, время и формат доставки персонализировать. Опубликованное должно было складываться в индексируемую базу знаний, аналитика — измерять потребление, а не отправку. Всё это внутри корпоративных требований к аутентификации, правам и аудиту.
Решение
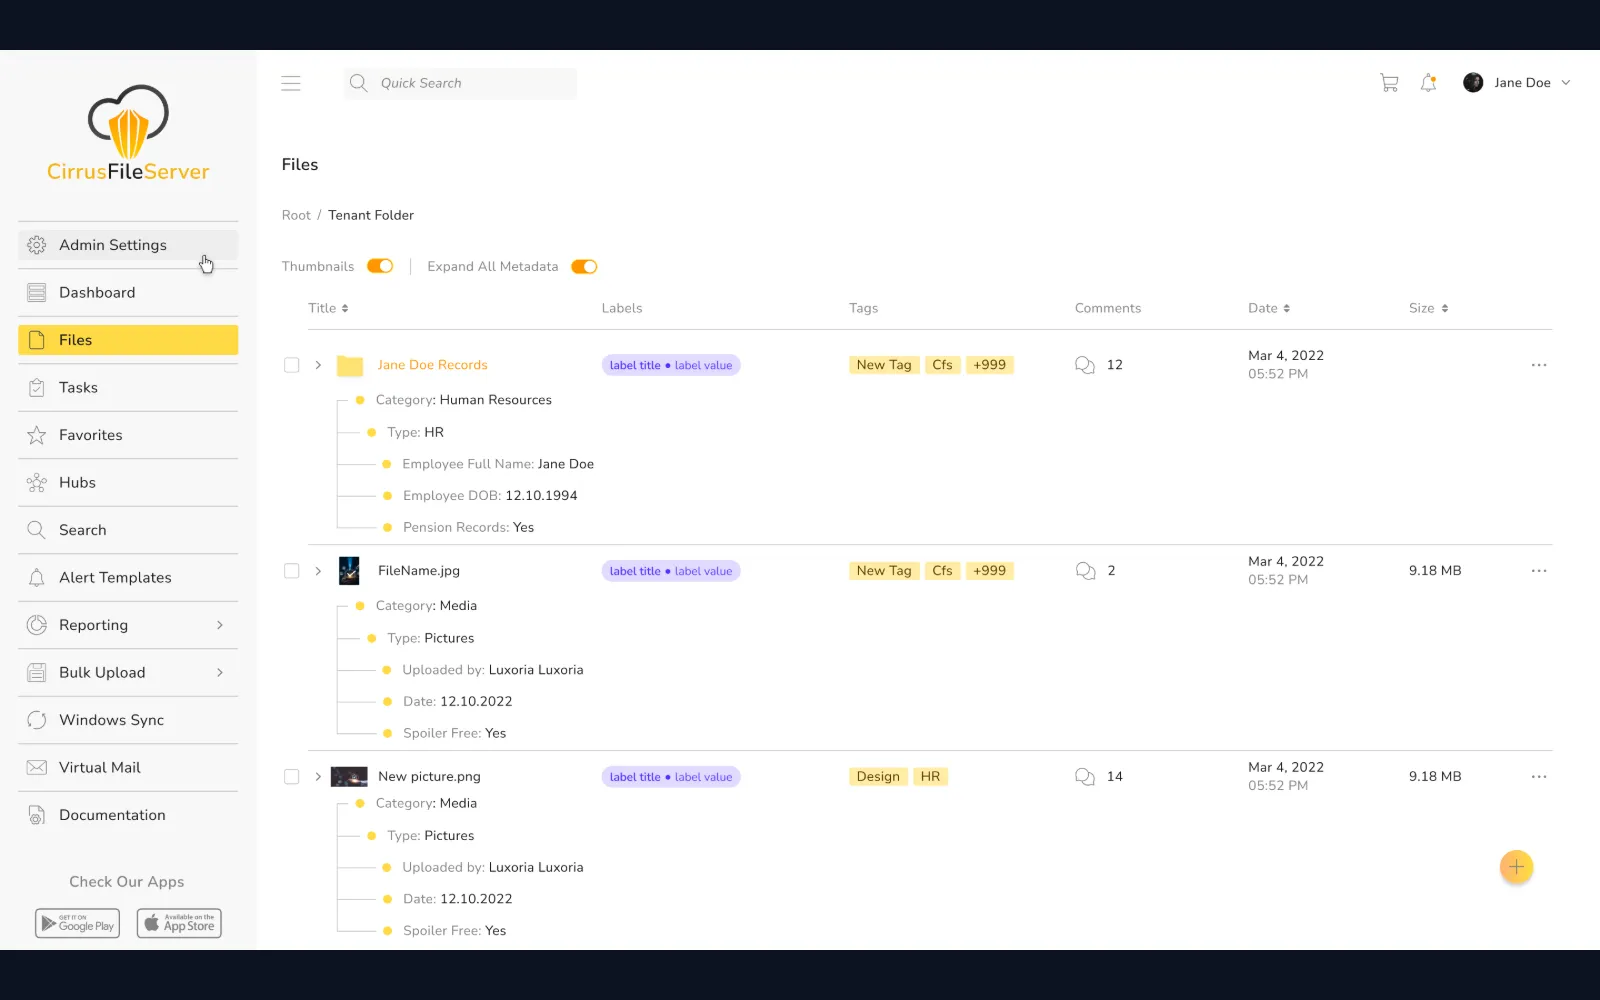
Десять форматов в одной модели. Это статьи и новости, короткие и полноформатные видео, прямые эфиры и их записи, аудиовыпуски и подкасты, баннеры и объявления. К ним добавляются события, галереи, внешние ссылки, опросы и квизы, тематические подборки из нескольких материалов. Всё живёт в общей медиабиблиотеке: один файл переиспользуется в разных материалах без повторной загрузки, а материал проходит единый жизненный цикл от черновика до архива.
Аудитория считается из оргструктуры. Статические и динамические аудитории строятся по стране и локации, бизнес-юниту, должности и роли, команде и руководителю, типу занятости, проекту или клиентскому направлению и произвольным атрибутам компании. Права на чтение и права на публикацию разведены. Автор видит расчётную аудиторию до отправки, а система заранее проверяет пересечения, ограничения и доступность каналов.
Редакционный цикл из десяти шагов. Сначала задают формат или шаблон, подтягивают материалы из библиотеки, пишут текст с тегами и категорией, настраивают правила доступа и комментирования, выбирают аудиторию. Дальше идут ИИ-преобразования и локализация, согласование, публикация сразу или по расписанию, веб- и пуш-уведомления и отчёт по доставке и потреблению. Материал можно снять с публикации или заменить новой версией, не ломая структуру категорий и накопленную аналитику.
Clarity AI: смотреть, читать, слушать. Из исходного видео, аудио, статьи или документа система готовит краткий пересказ, текстовую версию, аудиоверсию и визуальное представление. Из того же источника получаются транскрипт с таймкодами, субтитры и локализации на другие языки. Сотрудник сам выбирает, смотреть материал, читать или слушать: содержание одно, а формат подстраивается под ситуацию, доступность и привычки. Преобразования встроены в редакционный процесс и в приложение, отдельного сервиса для них нет.
Поиск по сказанному вслух. Индекс охватывает заголовки и текст, транскрипты аудио и видео, извлечённый текст PDF и документов, категории, теги, владельцев и связанные подборки. Сотрудник находит материал по фразе, прозвучавшей в середине часовой записи, даже если редактор не вписал её в заголовок. Результаты учитывают права доступа и персональную релевантность.
Аналитика потребления. События собираются по всему пути материала: кому он был доступен и доставлен, кто открыл, сколько времени читал или смотрел, на какой минуте остановил видео. Фиксируется и то, дошёл ли человек до конца, добавил ли материал в избранное, переслал ли, ответил ли на опрос и подтвердил ли ознакомление. Дашборд режет данные по периоду, категории, формату, подразделению, роли, локации и аудитории. Он показывает, где люди бросают материал и чем различаются сегменты.
Обязательное отделено от интересного. Для адаптации новичков, продуктового обучения и повторного ознакомления с политиками фиксируются доставка, начало, завершение и подтверждение ознакомления; прогресс переносится между устройствами, а ответственная команда видит статус по аудиториям.
Доступ, аудит и интеграции. Платформа поддерживает SSO и корпоративную модель идентификации, тенанты и рабочие пространства, роли и издательские зоны, динамические правила аудиторий. Есть локализация и доступность интерфейса, модерация, журнал административных действий, контроль скачивания и печати документов, управление сессиями и устройствами. Интеграции связывают платформу с каталогом сотрудников и HRIS, календарями, каналами уведомлений, BI и клиентскими API.
Результат
Массовые рассылки заменила адресная коммуникация, а семь источников — один вход. Редактор публикует материал один раз и видит, что с ним произошло: охват, завершения и отказы по ходу материала, разницу между подразделениями и то, какой формат сработал для какой аудитории. Сотрудник видит только то, что относится к нему, продолжает просмотр на другом устройстве, возвращается к незавершённому обучению и находит нужное по фразе из видео. HR и руководители получают подтверждаемое ознакомление с обязательными материалами. После рассылки опубликованное остаётся в базе знаний и доступно в поиске.
Команда вела продукт полностью: продуктовая стратегия и декомпозиция корпоративных сценариев, UX-исследование и информационная архитектура, дизайн CMS и приложения сотрудника. Разработка охватывала веб и мобильные клиенты, бэкенд и API, медиапайплайн, поиск и аналитику, ИИ-рекомендации и преобразование контента. На нас были и SSO, корпоративные интеграции, инфраструктура и мониторинг, тестирование, запуск и поддержка.